Driving-Bench: Sprachmodelle fahren einen echten Toyota
Drei Entwickler des Startups Axiom ließen vier Chatbots ohne Fahrtraining ans Lenkrad – nur GPT-6 Astra brachte den Parcours zu Ende.
Kurz gesagt
Nur GPT-6 Astra fuhr den Testparcours im Toyota Corolla zu 100 Prozent ab; Claude Fable 5.1 schaffte 45 Prozent, Grok 4.6 11 Prozent und GPT-5.6 Sol 6 Prozent.
Auf einen Blick
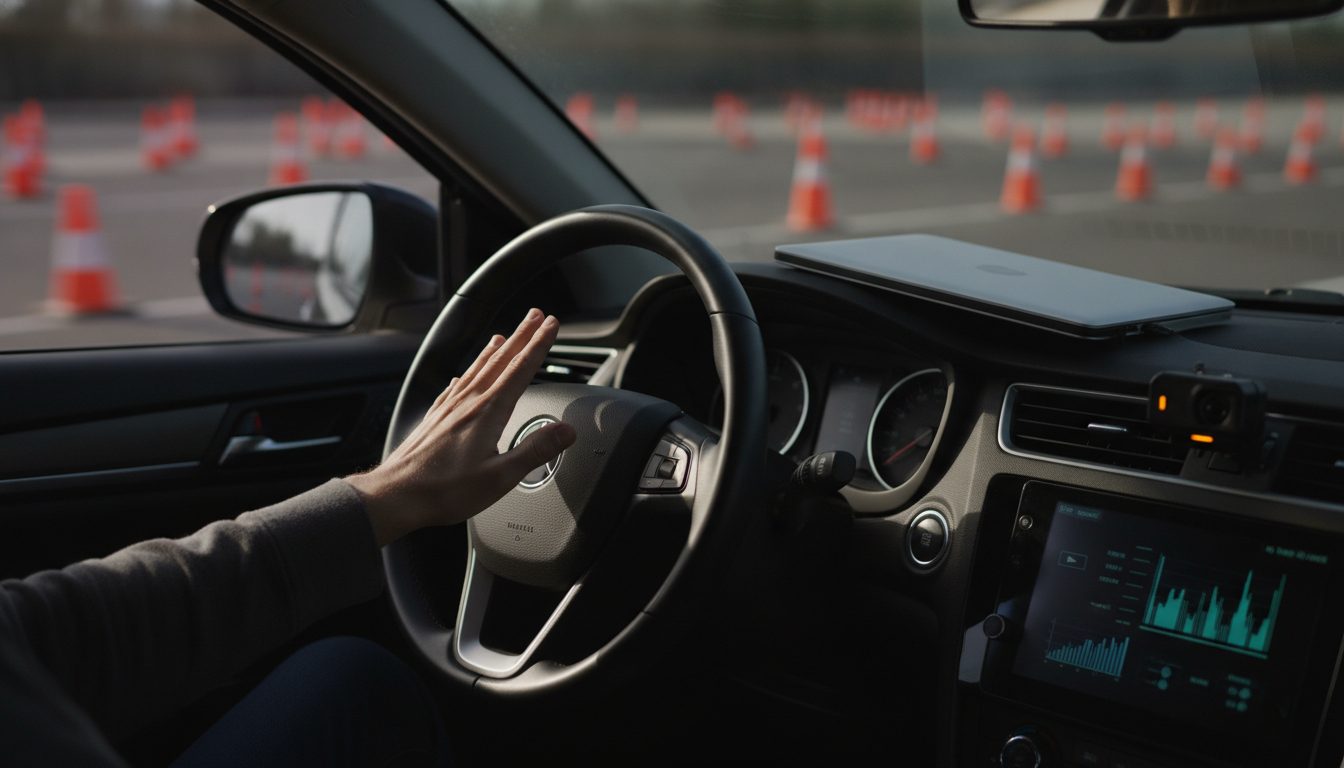
- Drei Entwickler des Startups Axiom ließen vier Sprachmodelle einen Toyota Corolla über einen Testparcours steuern.
- GPT-6 Astra absolvierte 100 Prozent des Parcours – langsam, aber ohne Abbruch.
- Claude Fable 5.1 erreichte 45 Prozent, Grok 4.6 kam auf 11 Prozent, GPT-5.6 Sol auf 6 Prozent.
- Der Versuchsaufbau liegt als Driving-Bench auf GitHub – nötig sind Code, Zusatz-Tools und Kameras.
- Kein Modell war fürs Fahren trainiert; Streckenlänge, Tempo und Sicherheitsvorkehrungen nennt die Quelle nicht.
Nur eines von vier getesteten Sprachmodellen hat den Testparcours in einem Toyota Corolla zu 100 Prozent abgeschlossen: GPT-6 Astra. Claude Fable 5.1 kam auf 45 Prozent, Grok 4.6 auf 11 Prozent, GPT-5.6 Sol auf 6 Prozent. Trainiert worden war keines dieser Modelle fürs Fahren.
Vier Chatbots, ein Serienauto
Autonome Fahrzeuge werden normalerweise von eigens dafür trainierten Algorithmen gesteuert. Drei Entwickler des Startups Axiom haben nach Angaben von t3n stattdessen Allzweck-Sprachmodelle von OpenAI, Anthropic und X.ai ans Steuer gesetzt – Systeme, die für Text, Code und Bilder gebaut sind. Alle vier brachten das Fahrzeug tatsächlich in Bewegung. Nur eines kam auch ans Ende der Strecke.
Das Ergebnis: ein sehr ungleiches Feld
- GPT-6 Astra: 100 Prozent des Parcours, langsam gefahren, aber ohne Abbruch
- Claude Fable 5.1: 45 Prozent
- Grok 4.6: 11 Prozent
- GPT-5.6 Sol: 6 Prozent
Bemerkenswert ist weniger der Sieger als der Abstand. Zwischen dem besten und dem zweitbesten Modell liegen 55 Prozentpunkte – mehr als zwischen dem zweiten und dem letzten Platz. Ein Generationssprung innerhalb derselben Modellfamilie fällt ebenfalls auf: GPT-6 Astra erreichte das Sechzehnfache des Werts von GPT-5.6 Sol.
Driving-Bench liegt offen auf GitHub
Das Team hat seinen Versuchsaufbau unter dem Namen Driving-Bench über GitHub veröffentlicht. Wer den Code, zusätzliche Tools und Kameras zusammenstellt, kann den Versuch den Angaben zufolge selbst wiederholen. Damit ist das Ergebnis prinzipiell nachprüfbar – anders als bei internen Demovideos, die sich nicht gegenprüfen lassen.
Woher die Fahrfähigkeit kommen könnte
Eine Erklärung sieht das Team im Trainingsmaterial: Neben Bildern und Videos fließen inzwischen auch 3D-Modelle in das Training großer Sprachmodelle ein. Einer der Entwickler kommentierte das Ergebnis mit der Bemerkung, vielleicht sei die AGI ja doch schon da. Das ist eine Zuspitzung, keine Messgröße – belegt ist bislang nur die abgefahrene Strecke.
Was offenbleibt
Die vorliegende Quelle nennt weder die Namen der drei Entwickler noch Länge, Aufbau oder Hindernisse des Parcours. Auch Angaben zu Geschwindigkeit, Reaktionszeit pro Fahrentscheidung und zu Sicherheitsvorkehrungen fehlen. Ohne diese Zahlen lässt sich nicht beurteilen, wie schwer die Aufgabe war und wie weit die Prozentwerte von einem Fahrversuch im Straßenverkehr entfernt sind. Details stehen in der Meldung bei t3n.
Häufige Fragen
Welches KI-Modell hat den Fahrtest gewonnen?
GPT-6 Astra. Es absolvierte den Testparcours im Toyota Corolla als einziges Modell zu 100 Prozent, wenn auch langsam.
Wie gut hat Claude Fable 5.1 beim Fahren abgeschnitten?
Claude Fable 5.1 kam auf 45 Prozent des Parcours und landete damit auf Platz zwei vor Grok 4.6 mit 11 und GPT-5.6 Sol mit 6 Prozent.
Kann man den Versuch mit Driving-Bench selbst nachbauen?
Ja, das Team hat den Aufbau über GitHub bereitgestellt. Nötig sind laut Beschreibung der Code, zusätzliche Tools und Kameras; Angaben zu Kosten und Sicherheitsauflagen macht die Quelle nicht.